

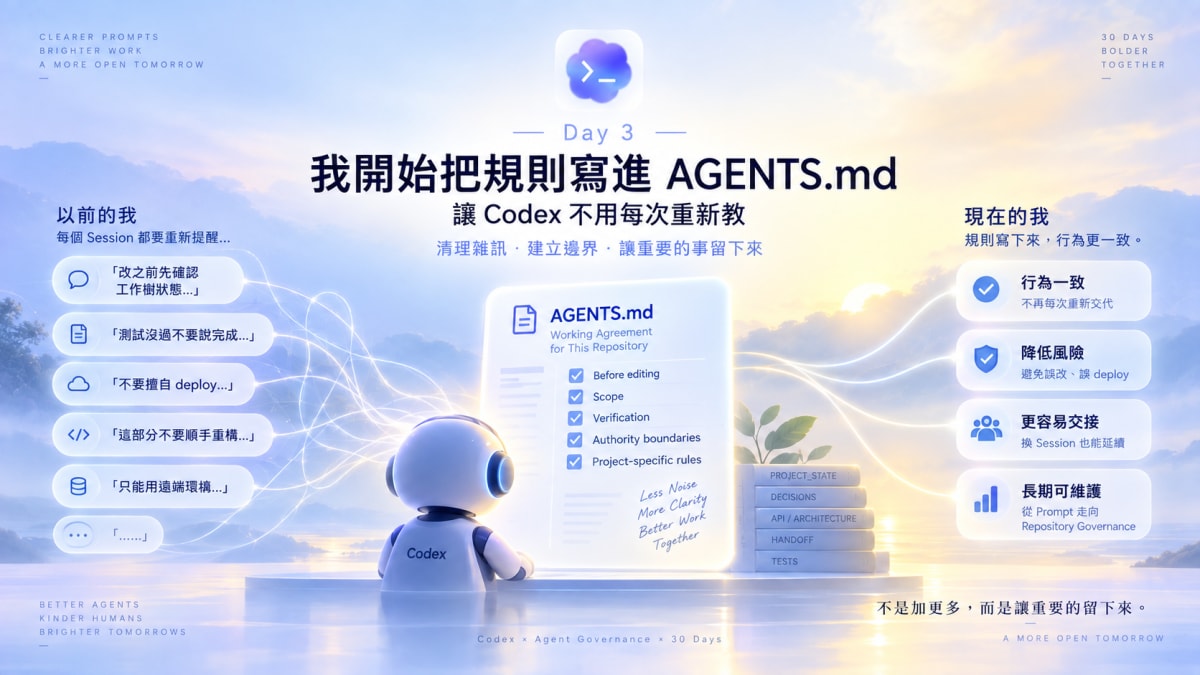
前兩天談到,我原本以為只要把需求講清楚、讓 Codex 繼續做下去,就能把開發速度一路往上拉。
但專案做久之後,我開始遇到另一個問題。
不是 Codex 不會寫。
而是:
同一件事情,我怎麼好像每隔幾個 Session,就要重新講一次?
例如:
這些規則第一次講,很合理。
第二次提醒,也還能接受。
但當專案越來越大、Session 越來越多,我開始發現:
如果每次都靠 Prompt 重新交代,那些重要的工程規則根本沒有留在專案裡。
這也是我開始認真使用 AGENTS.md 的原因。
一開始我也很容易把 AGENTS.md 想成:
把 Prompt 寫長一點,放進檔案裡。
但後來我覺得這個理解不太對。
如果只是把所有想到的事情全部塞進去,最後很可能變成:
AGENTS.md
├─ coding style
├─ branch 規則
├─ 測試規則
├─ deploy 規則
├─ API 規格
├─ 架構說明
├─ Bug 歷史
├─ Prompt 技巧
├─ 專案背景
└─ 其他想到什麼就補什麼
看起來資訊很多,
實際上卻會出現另一種 Context Pollution。
我現在比較把有用的 AGENTS.md 當成:
這個 Repository 裡,Agent 做事時必須遵守的「工作契約」。
它不是拿來保存所有知識。
而是告訴 Agent:
在這個專案裡,你應該怎麼工作。
假設我今天叫 Codex:
幫我修正登入問題。
如果沒有其他規則,它可能採取很多合理路線:
這些行為單獨看都不一定錯。
問題是:
它們不一定符合我這個專案的工作方式。
例如我的某些專案裡,我會要求:
先 trace
→ 找 root cause
→ 限定 bounded scope
→ 修改
→ targeted tests
→ regression
→ 回報 evidence
而不是:
看到錯誤
→ 猜原因
→ 直接修改
→ 看起來正常
→ 完成
這種差異不應該每一次都靠聊天提醒。
我開始把它寫進 Repository。
我現在很重視的一件事情,就是:
不要假設工作目錄是乾淨的。
因為使用 AI Agent 開發之後,很容易同時存在:
如果 Agent 一進來就開始改,很容易發生:
「功能做對了,但把別人的東西一起蓋掉。」
類似這種規則,很適合存在 AGENTS.md:
## Before editing

- Inspect repository status before making changes.
- Preserve existing user changes.
- If target files already contain unrelated modifications, perform a collision check first.
- Do not revert or overwrite existing work unless explicitly requested.
這不是 coding style。
而是 Agent 的操作安全規則。
這也是我後來越來越重視的東西。
我以前很常下這種 Prompt:
幫我把這個功能修好。
但「修好」的範圍非常模糊。
Agent 有時候會發現:
既然這裡要改,那旁邊這裡也可以一起重構。
技術上可能沒錯。
但實際專案裡,修改範圍越大:
我開始建立一個觀念:
先解決這次要解決的問題,不要順手改善整個世界。
例如:
## Scope

Keep changes within the approved task scope.

Do not:
- perform unrelated refactors
- rename unrelated files
- change architecture unless required
- fix unrelated issues discovered during implementation

Report unrelated findings separately.
這後來也逐漸變成我常用的:
bounded scope。
這可能是我目前最在意的規則之一。
AI 寫 Code 很快。
但:
Code 寫完
不代表:
工作完成
中間至少還差:
語法正確
↓
targeted test
↓
相關 regression
↓
lint / build
↓
必要的 runtime evidence
我會希望 Agent 最後不能只說:
已完成。
而是必須告訴我:
修改了什麼
測了什麼
哪些 PASS
哪些沒有測
還有哪些已知風險
這種規則同樣很適合寫進 Repository:
## Verification

Do not claim completion without verification.

At minimum:
1. Run targeted tests for the changed behavior.
2. Run relevant regression tests.
3. Run lint/build when applicable.
4. Report commands and results.
5. Clearly state anything that was not verified.
這件事看起來只是多幾行文字。
但它會直接改變 Agent 對「完成」的定義。
做到這裡,我開始發現另一個很重要的邊界。
有些事情 Agent 很適合自己做:
但有些事情,即使技術上做得到,也不代表它應該自己決定。
例如:
這些動作的問題不是「AI 會不會」。
而是:
誰有權決定?
我後來開始把這些也變成明確規則。
例如:
## Authority boundaries

Do not perform the following without explicit approval:

- production deployment
- database schema migration
- remote production data mutation
- destructive operations
- material authentication or authorization changes
這讓我慢慢意識到:
AGENTS.md 不只是技術文件。
它開始有點像 AI 開發裡的:
Operating Policy。
這也是我現在很想避免的問題。
當我開始覺得 AGENTS.md 很好用之後,很容易什麼都想往裡面放。
例如:
這個 Bug 以前怎麼修的,要不要放?
API 規格要不要放?
系統架構要不要放?
上次決策要不要放?
如果全部都放,
很快又會回到原本的問題:
重要資訊被大量 Context 淹沒。
我會開始區分不同文件的責任。
大致上會變成:
AGENTS.md
→ Agent 應該怎麼工作

PROJECT_STATE.md
→ 專案現在在哪裡

DECISIONS.md
→ 為什麼以前做了這些決定

API / PRODUCT / ARCHITECTURE
→ 系統本身的規格

Handoff
→ 這一輪做到哪、下一輪接什麼

Tests
→ 哪些行為必須持續成立

Git
→ 程式碼實際的演進歷史
這個拆分對我後來非常重要。
因為它讓「記憶」不再是一個檔案要解決全部問題。
做到這裡之後,我對 AI Coding 的理解也開始改變。
最早我的工作方式比較像:
我
↓
Prompt
↓
Codex
↓
Code
後來慢慢變成:
          Repository
        ↙     ↓      ↘
 AGENTS.md   Docs    Tests
      ↘       ↓       ↙
             Codex
               ↓
             Code
Agent 不再只依賴「我這次聊天講了什麼」。
它開始受到整個 Repository 裡的規則與證據約束。
這也是我第一次很明顯感覺到:
AI Coding 要長期使用,Prompt Engineering 可能只是第一步。
再往後走,
問題會慢慢變成:
怎麼設計一個環境,讓 Agent 即使換 Session、Context 被壓縮,甚至換另一個 Agent,仍然知道應該怎麼工作?
當然,把規則寫進 AGENTS.md 之後,問題並沒有全部消失。
因為很快又會遇到下一層:
這也是我後來開始把部分重複規則抽成 Shared Skills 的原因。
但那已經是後面的故事了。
回頭看,AGENTS.md 對我最大的價值,不是讓 Codex 變得更聰明。
而是第一次讓我把:
「我腦中知道 Agent 應該怎麼做」
變成:
「Repository 本身就知道 Agent 應該怎麼做」。
如果只是偶爾讓 AI 幫忙改一個小功能,
一個清楚的 Prompt 就已經很好用。
但當 AI 開始:
這時候只靠 Prompt,就會開始變得脆弱。
而 AGENTS.md 是我第一次把這些「合作規則」正式放回 Repository 的嘗試。
它解決的不是:
AI 要寫什麼 Code?
而是:
AI 在這個專案裡,應該用什麼方式工作?
這兩個問題,看起來很像。
但做到後面,我發現它們差很多。
把工作規則寫進 Repository 之後,我原本以為 Context 問題會改善很多。
但實際跑久了,我又遇到另一件事:
規則記住了,專案的「現在狀態」卻還是可能在長 Session 裡慢慢模糊。
下一篇,我會繼續往 Context 的問題走:
當 Agent 已經知道「該怎麼工作」,我們又該怎麼讓它知道「專案現在走到哪裡」?


 iThome鐵人賽
 看影片追技術